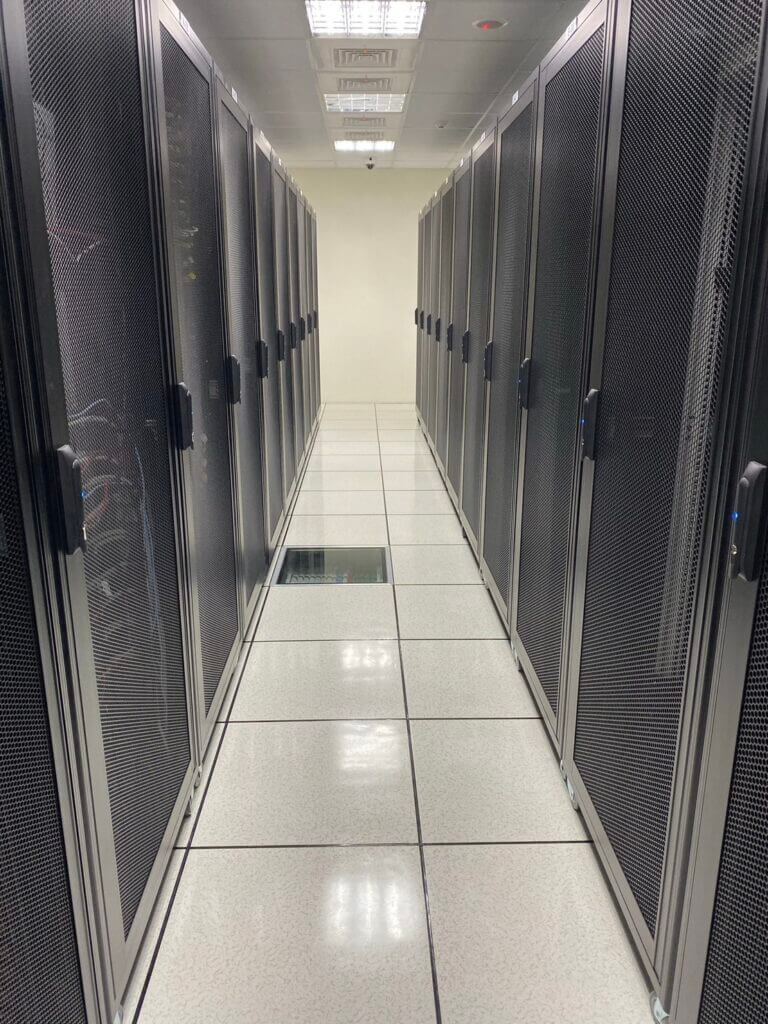

2026 年下半年,IT 基礎設施規劃已不再是年度例行公事。AI 工作負載的指數級成長、儲存在線容量持續膨脹,以及全球碳足跡揭露標準收緊,三者交織迫使企業在 Q3 至 Q4 做出關鍵投資決策。本文結合最新產業數據與真實案例,協助 IT 決策者規劃下半年基礎設施藍圖,並提供可執行的預算編列策略。
一、AI 基礎設施:GPU 叢集與網路升級
2026 年,GPU 機架密度已從傳統機房的 5–10 kW 跳升至 30–60 kW,NVIDIA GB200 NVL72 機架更達到 120–132 kW,是一般企業伺服器的十倍。Uptime Institute 調查指出,僅約 1% 的營運商已部署超過 100 kW 機架,但 2026 年下半年起,300 kW 以上的機架級系統將陸續出貨,直液冷卻(DLC)已從可選配置變為必要基礎設施。
網路層面,InfiniBand 與 Ethernet 形成雙軌格局。Dell’Oro Group 數據顯示,2025 年第三季 Ethernet 已占 AI 後端交換器銷售量的三分之二以上,800 Gbps 端口成為主流。企業規劃時須區分訓練叢集(需 400G InfiniBand 或 RoCEv2)與推理叢集(可用 25G/100G Ethernet),避免過度投資。Meta 在實測中證實,妥善調校的 RoCEv2 與 InfiniBand 訓練效能相當,32 GPU 規模下三年可節省約 60 萬美元。
真實案例:一家大型金融分析企業在 2025 年部署 64-GPU H100 叢集時,提前 9 個月完成機房液冷改造與 100G 網路升級,使 GPU 到貨即可上線。專案總成本中 GPU 硬體占 55%、網路 10%、儲存 3%、機房電力與散熱 22%——網路與散熱的提前投入使 PUE 從 1.5 降至 1.15,每年節省約 3 萬美元電費。
二、儲存現代化:NVMe 與 SAN 到 NAS 整合
傳統 SAN 架構在 2026 年面臨雙重壓力:一是效能瓶頸——HDD 型 SAN 已無法滿足 AI 訓練中 0.6 GB/s 每 GPU 的持續檢查點寫入需求;二是成本結構——多套陣列的授權與維護費累計往往超過硬體本身。全快閃(All-Flash)NVMe 架構與 NAS 整合成為主流升級路徑。
升級方向包括:以 NVMe-oF 取代傳統 FC SAN、將多套同質化陣列整合為統一命名空間、以及將冷熱分層策略納入設計(本地 NVMe 熱數據 → 平行檔案系統 → 物件儲存冷數據)。NetApp、Dell、HPE 均已提供無複寫遷移(Copy-Free Transition)技術,可將數月的遷移窗口縮短至小時級。
真實案例:一家全球快速消費品(FMCG)企業將 UK 資料中心的老舊 IBM V7000 Gen2 陣列替換為兩台 IBM FlashSystem 5200 全快閃陣列,機架空間縮減 40%、電力消耗下降約 35%,年維護成本降低近一半。另一家石油公司利用 NetApp 無複寫遷移技術,將 EOL 儲存平台遷移完成時間從預計三個月壓縮至 10 小時生產切換,支援成本降低三分之一,ROI 在 12 至 18 個月內收回。
三、永續目標:PUE 與 RE100 路徑
2026 年是資料中心永續合規的關鍵年。歐盟 Energy Efficiency Directive(EED)要求 IT 功率 500 kW 以上的設施每年申報 PUE、WUE 與再生能源比例;德國 EnEfG 更進一步規定 2026 年 7 月 1 日後投運的資料中心 PUE 必須低於 1.2,且至少 10–15% 廢熱回收。中國則於 2025 年將全國資料中心平均 PUE 目標降至 1.5 以下。
RE100(100% 再生能源)在 2026 年出現分化:Meta 因資料中心擴張需要天然氣備援而退出 RE100 聯盟,但 Google 於 2025 年單一年度簽訂 12 GW 新增清潔能源合約,創歷史新高,其 2025 年機隊平均 PUE 達 1.09。對企業而言,規劃重點在於:量化現況 PUE 基線、評估液冷與自由冷卻(Free Cooling)改造投資、以及與綠能供應商簽訂長期購電協議(PPA)鎖定成本。
真實案例:台積電 2024 年電力消耗達 255.5 億度(占全國 9%),綠電比例 14.1%,已簽訂 4.4 GW 再生能源合約,目標 2030 年綠電占比 60%、2040 年 100%。另一案例為一家印度資料中心服務商,透過 231 MW 綠能 PPA 與 AI 驅動的能量管理系統,將 PUE 從 1.42 降至 1.18,年減碳 1.2 萬噸,並設定 2030 年 RE100 目標。
四、網路現代化:10G 到 25G/100G 躍升
2026 年企業網路的「預設升級」已從加快存取端口轉向平衡設計:10G 作為常見存取基準、25G 用於高密度熱區、100G 上行鏈路(Uplink)防止匯聚層成為隱藏瓶頸。SFP28 端口向後相容 SFP+,允許分階段遷移——先升級交換器、再依維護窗口逐步更換 NIC,無需一次性大規模切換。
關鍵指標:Spine 上行持續利用率超過 60%、儲存複製頻寬受限、或部署 NVMe-oF 時,即應啟動 100G 升級評估。48 台伺服器的機架從 10G 升至 25G,總投資約 3 萬美元(交換器 1.7 萬、NIC 1.2 萬、光模組與電纜 0.12 萬),每台伺服器僅 629 美元換取 2.5 倍頻寬。
真實案例:一家大型學術機構將服役八年的 HPE ProLiant Gen8 叢集升級至 Gen11,搭配 HPE Alletra MP 全快閃 NVMe 儲存與 Aruba CX 8325 25/100G ToR 交換器,機架佔用縮減 50%、電力消耗下降 35%,並新增 NVIDIA L40S GPU 容量支援研究工作負載,六週分階段切換完成遷移。
五、容量規劃與彈性架構
PwC 預測 2026 年全球資料中心投資約 8,000 億美元,其中 ICT 設備(伺服器、GPU、儲存、網路)每 4–6 年需全面更新。每 1 美元機房建設資本支出,長期承諾約 12 美元 ICT 設備支出。企業規劃須考慮:GPU 經濟壽命僅 2–3 年(遠短於財務折舊的 5 年)、訓練與推理工作負載的峰值差異(GPU 訓練階段可造成 30–60% 的瞬間負載波動),以及跨機房/跨數據中心的擴展能力(Scale-Across)。
彈性架構策略包括:模組化/預製機房(Prefab)縮短交付期 50%、N+1 與 2N 冗餘依工作負載分級配置(訓練叢集可 N+1、推理叢集需 2N)、以及將 800 VDC 機架供電納入基礎設計以應對下一代 Rubin 世代 600 kW 機架密度。
真實案例:xAI 在 Memphis 的 Colossus 資料中心以 122 天完成建廠,採用模組化預製結構與現場天然氣渦輪機輔助供電,搭配 300 MW 電網併網,使 10 萬 GPU 訓練叢集在 GPU 到貨前即具備完整電力與散熱基礎設施。Meta 則採用「自有 + 租賃」雙軌策略,自有設施承接長期訓練負載,租賃機房提供彈性推理容量,避免過度資本鎖定。
預算規劃實務建議
- 硬體僅占 5 年 TCO 的 35%:電力($54.6 萬/年/100GPU)、散熱、人員(4–6 FTE)、維護與軟體授權合計遠超硬體。規劃時以硬體成本的 165%–200% 估算 5 年總成本。
- GPU 折舊採 3 年而非 5 年:經濟壽命遠短於財務折舊期,加速折舊可反映真實價值衰減,殘值約 20–40%。
- 電力成本差 1 分/度差 17.5 萬美元:100-GPU 叢集在 $0.08/kWh 與 $0.12/kWh 之間的年差額達 17.5 萬美元,选址與綠電 PPA 應優先評估。
- 散熱改造 ROI 明確:液冷系統前期多投 50 萬美元,年省電力 5 萬美元,10 年回收——但對 AI 密度機房而言,散熱是功能性前提而非可選投資。
- 分階段編列:Q3 完成評估與設計、Q4 簽署 PPA 與主要硬體訂單(GPU 交期 9–12 個月)、翌年 Q1 機房改造、Q2 上線,確保 GPU 到貨即產能。
2026 年下半年是基礎設施投資的窗口期:GPU 供應鏈雖緊張但仍有規劃空間,網路與散熱改造若未在 Q4 前啟動,將直接延後翌年 AI 工作負載上線時程。將電力、散熱與網路視為與 GPU 同等重要的設計約束,而非下游實施細節,是當前業界共有的核心經驗。
華盈科技提供從基礎設施評估、架構設計到專案執行的端到端服務,涵蓋 GPU 叢集部署、儲存現代化、網路升級與永續合規諮詢。歡迎來電 02-7730-7729 或致信 service@hytechtw.com 預約免費基礎設施健康檢查,讓我們協助您在下半年的規劃中掌握先機。